Ich betreibe ab sofort einen Tile-Server im modernen MVT-Format, der alle Einheiten des Marktstammdatenregisters als Vektor-Kacheln bereitstellt. Der Kachelserver kann in jedes moderne Geoinformationssystem (GIS), wie QGIS oder ArcGIS eingebunden werden, aber auch sehr einfach in jede Website eingebettet werden.
Der Tile-Server darf ohne Auflagen frei verwendet werden.
Alle verfügbaren Layer, Metadaten/Attribute und Beispiele für die Einbindung, sind auf der Beschreibungsseite mastr.nachtsieb.de/tile-server dokumentiert.
Beispiel: Windenergieanlagen auf einer OpenStreetMap-Karte
Hier befindet sich ein Beispiel für eine direkte IEnbettung, OpenStreetMap dient als Basis-Layer, darüber befinden sich die MaStR-Vektor-Kacheln vom Tile-Server.
Die Einbettung geschieht mittels MapLibre, was lokal von nachtsieb.de heruntergeladen wird. Über das Auswahlfeld lässt sich zwischen den Energieträgern wechseln. Fährt man mit der Maus über einen Punkt, erscheinen die Attribute der Einheit:
Zwei Neuerungen gibt es in der MaStR-App unter mastr.nachtsieb.de: eine Karte mit den Standorten der Anlagen und den kompletten MaStR-Datenbestand als Download.
Karte
Auf der neuen Seite „Karten” wählt man Energieträger und Bundesland oder ganz Deutschland aus und sieht die Anlagen als Punkte auf einer Karte, eingefärbt nach Betriebsstatus. Damit erkennt man auf einen Blick, welche Anlagen in der eigenen Region stehen. Ein Klick auf einen Punkt/Einheit zeigt Name, Leistung, Standort und Status der Anlage. Koordinaten veröffentlicht das MaStR erst ab 30 kW, kleinere Anlagen fehlen daher auf der Karte. Bei Solar und Stromspeichern kann man nur nach Bundesländern filtern, da alle Anlagen auf der Karte einfach zu viele wären..
Kompletter Datenbestand als Download
Auf der Seite „Downloads” steht jetzt mastr-latest.sql bereit: ein
vollständiger Datenbank-Auszug des Registers (PostgreSQL), täglich neu
erzeugt, mit einer Anleitung zum Einspielen in die eigene Datenbank.
So lässt sich das ganze Register lokal und schnell auswerten,
ohne auf die Webseite angewiesen zu sein. Download unter
mastr-static.nachtsieb.de/export/mastr-latest.sql.
Ausblick: eigener Tile-Server
Als Nächstes ist ein eigener Tile-Server auf Basis von Vektor-Kacheln (MVT) geplant. Damit kann man den MaStR-Datenbestand leichter in vorhandene GIS-Systeme integrieren.
Wie gut kennst du die Windkraftanlagen in Deutschland? Teste es unter nachtsieb.de/wka-quiz. Viel Spaß beim Raten!
In diesem Beitrag stelle ich ein Projekt vor, das ich seit April 2025 betreibe: die Aufbereitung der öffentlichen Daten des Marktstammdatenregisters der Bundesnetzagentur, kurz MaStR, in besser nutzbare Formate. Die Ergebnisse stehen unter mastr.nachtsieb.de zur Verfügung.
Was ist das Marktstammdatenregister?
Das MaStR ist das zentrale behördliche Register für den deutschen Strom- und Gasmarkt. Seit Januar 2019 sind alle Marktakteure verpflichtet, sich und ihre Anlagen zu registrieren - von Netzbetreibern über Stromlieferanten bis zu Betreibern von Windenergie-, Solar- und Speicheranlagen. Die Registrierung ist Voraussetzung für die EEG-Förderung. Das Register löste das bisherige Anlagenregister und das PV-Meldeportal ab und liefert Behörden, Politik und Energiewirtschaft ein umfassendes Bild des Energiesystems. Inzwischen sind mehr als 6,7 Millionen Datensätze erfasst.
Ein wesentlicher Aspekt: Die Daten sind öffentlich. Die Bundesnetzagentur stellt täglich einen Gesamtdatenauszug als XML-Dump zum Download bereit, lizenziert unter der Datenlizenz Deutschland, Namensnennung 2.0 (dl-de/by-2.0).
Die Rohdaten und ihre Grenzen
Der Gesamtdatenauszug umfasst unkomprimiert etwa 60 GiB an XML-Daten und wächst kontinuierlich. Die Verarbeitung dieser Datenmenge stellt eine erhebliche technische Herausforderung dar. Zwar bietet die Bundesnetzagentur eine Websuche an, für eigene Analysen, Filterungen oder die Weiterverarbeitung in anderen Formaten ist der XML-Dump jedoch nur bedingt geeignet.
Aus meiner Sicht ist das bedauerlich. Die Daten betreffen schließlich uns alle - den Ausbau der erneuerbaren Energien, die Energiewende, die Frage, welche Anlagen in Deutschland stehen und betrieben werden. Sie sollten nicht nur öffentlich, sondern auch nutzbar sein.
Mein Projekt: mastr-tool und mastr-app
Um diese Lücke zu schließen, habe ich zwei Open-Source-Komponenten entwickelt, die auf Codeberg veröffentlicht sind:
- mastr-tool - das Backend: Ein Python-Tool, das den XML-Dump automatisiert herunterlädt, in eine PostgreSQL-Datenbank importiert, mit UTM-Koordinaten anreichert und in die Formate CSV, Parquet und Excel exportiert. Ein Scheduler prüft alle 30 Minuten, ob ein aktualisierter Dump vorliegt.
- mastr-app - das Frontend: Eine Web-Anwendung, über die die Daten durchsucht und gefilterte Ergebnisse heruntergeladen werden können, beispielsweise alle Windenergieanlagen eines Bundeslandes.
Der Betrieb erfolgt selbst gehostet auf Kubernetes, bereitgestellt über Helm-Charts. Der dafür erforderliche Speicherplatz von mindestens 70 GiB ist erheblich, wird von mir jedoch in Kauf genommen.
Nutzung
Die Anwendung ist unter mastr.nachtsieb.de erreichbar. Dort lassen sich Windenergieanlagen nach Bundesland filtern und die Ergebnisse als CSV, Parquet oder Excel herunterladen. Die tagesaktuellen Gesamtexporte stehen unter mastr-static.nachtsieb.de zum automatisierten Download bereit. Alle Solar-Anlagen-Dateien stehen ebenfalls als CSV und Parquet zum Download zur Verfügung.
Hinweis: Die Anwendung ist derzeit nicht für mobile Endgeräte optimiert.
Bei welcher Krankenkasse sind in den Regelleistungen Behandlungen mit Homöopathie möglich? Die folgende Übersicht versucht die Frage für einige gesetzliche Krankenkassen zu beantworten. Es sind nur die mitgliederstärksten Krankenkassen verzeichnet. Die Erhebung wurde im Mai 2021 durchgeführt und es besteht keine Garantie auf Vollständigkeit.
Das Ergebnis ist sehr unerfreulich, es sind eindeutig zu viele Krankenkassen die Homöopathische “Behandlungen” bezahlen. Am dreistesten ist sicherlich die HKK, welche es unter dem Namen Naturarzneimittel in ihrem Katalog aufführt.
Wählt weise!
Krankenkassen, die teilweise alternative Medizin anbieten
- KKH
- Heilpraktikerbehandlung nur über Bonusprogramm
- Akupunktur nur bei chronischem Leiden
- Osteopathie
- IKK
- Pro Jahr maximal 150 Euro für Osteopathie
- Debeka BKK
- Akupunktur bei zertifizierten Ärzten
- Keine Behandlung bei Heilpraktikern
- Osteopathie: maximal sechs Sitzungen pro Kalenderjahr, jedoch nicht mehr als 40 EUR je Sitzung
- AOK
- Akupunktur (chronische Schmerzen, Vertragsarzt)
Krankenkassen, die Homöopathie unterstützen
- Barmer
- TK
- DAK
- HKK
- getarnt unter dem Deckmantel Naturarzneimittel
- HEK
- BKK24
- Heimatkrankenkasse
- Novitas BKK
- Knappschaft
- Landwirtschaftskrankenkasse
- BKK-Mobil
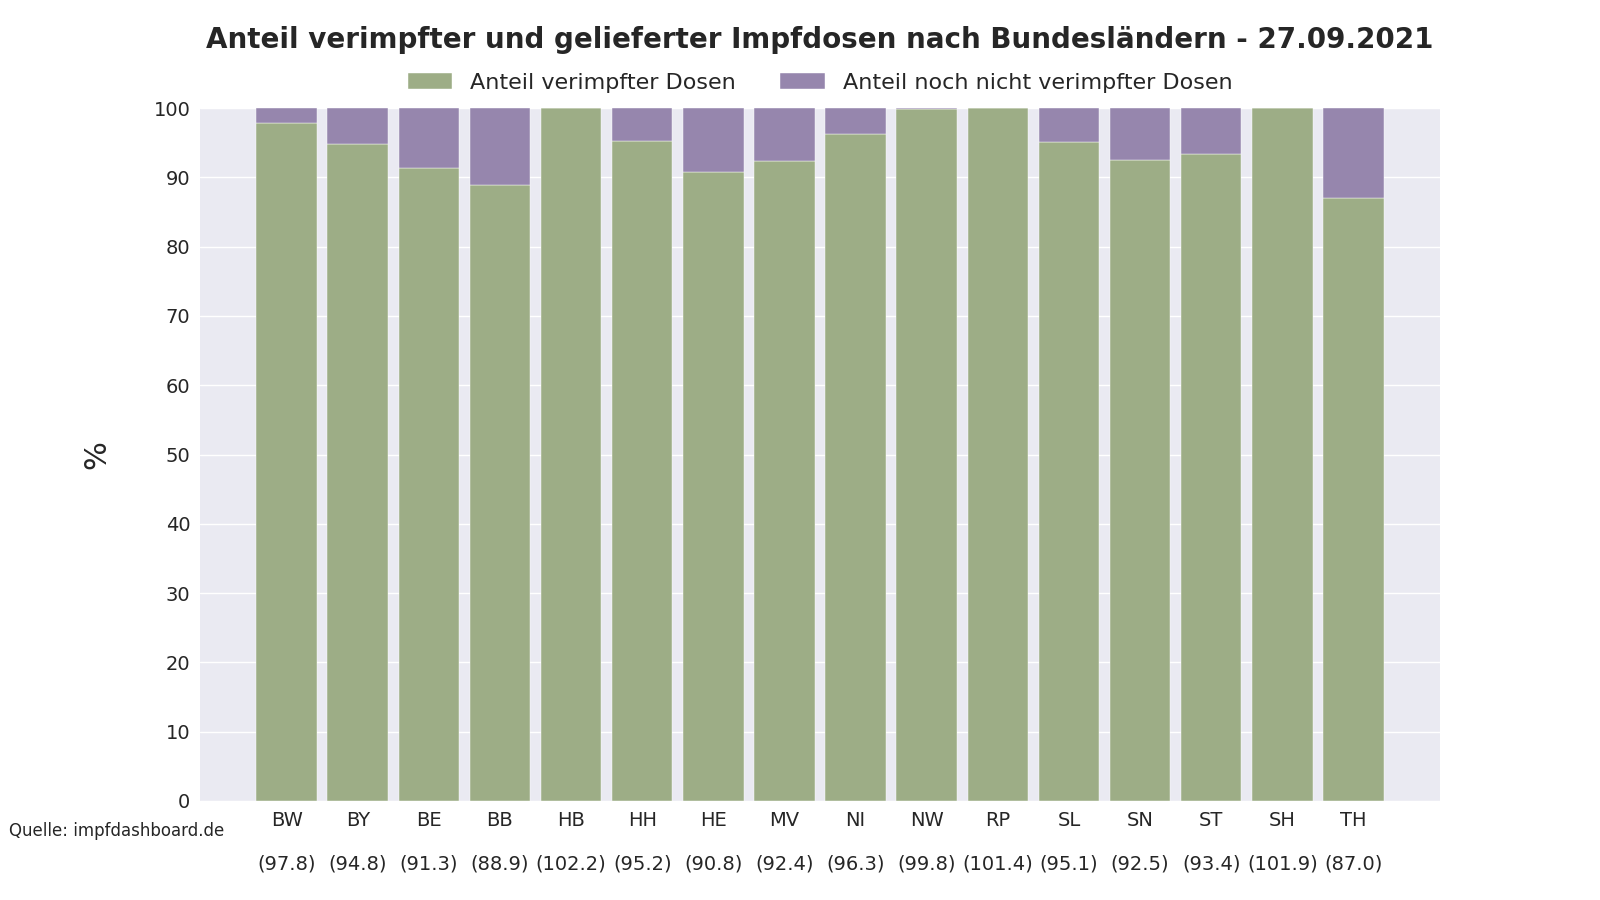
Das Impfdashboard des Bundesministeriums für Gesundheit bietet viele Informationen zum Impffortschritt. Jedoch fehlt ein Vergleich der Bundesländer und ihrer verimpften Dosen im Verhältnis zu den gelieferten Dosen.
Die folgende Grafik bietet diesen Vergleich und wird täglich aktualisiert. Als Quellen dienen die zur Verfügung gestellten Daten des Impfdashboards. Sie ist auch im Bereich covid19-plots hinterlegt.
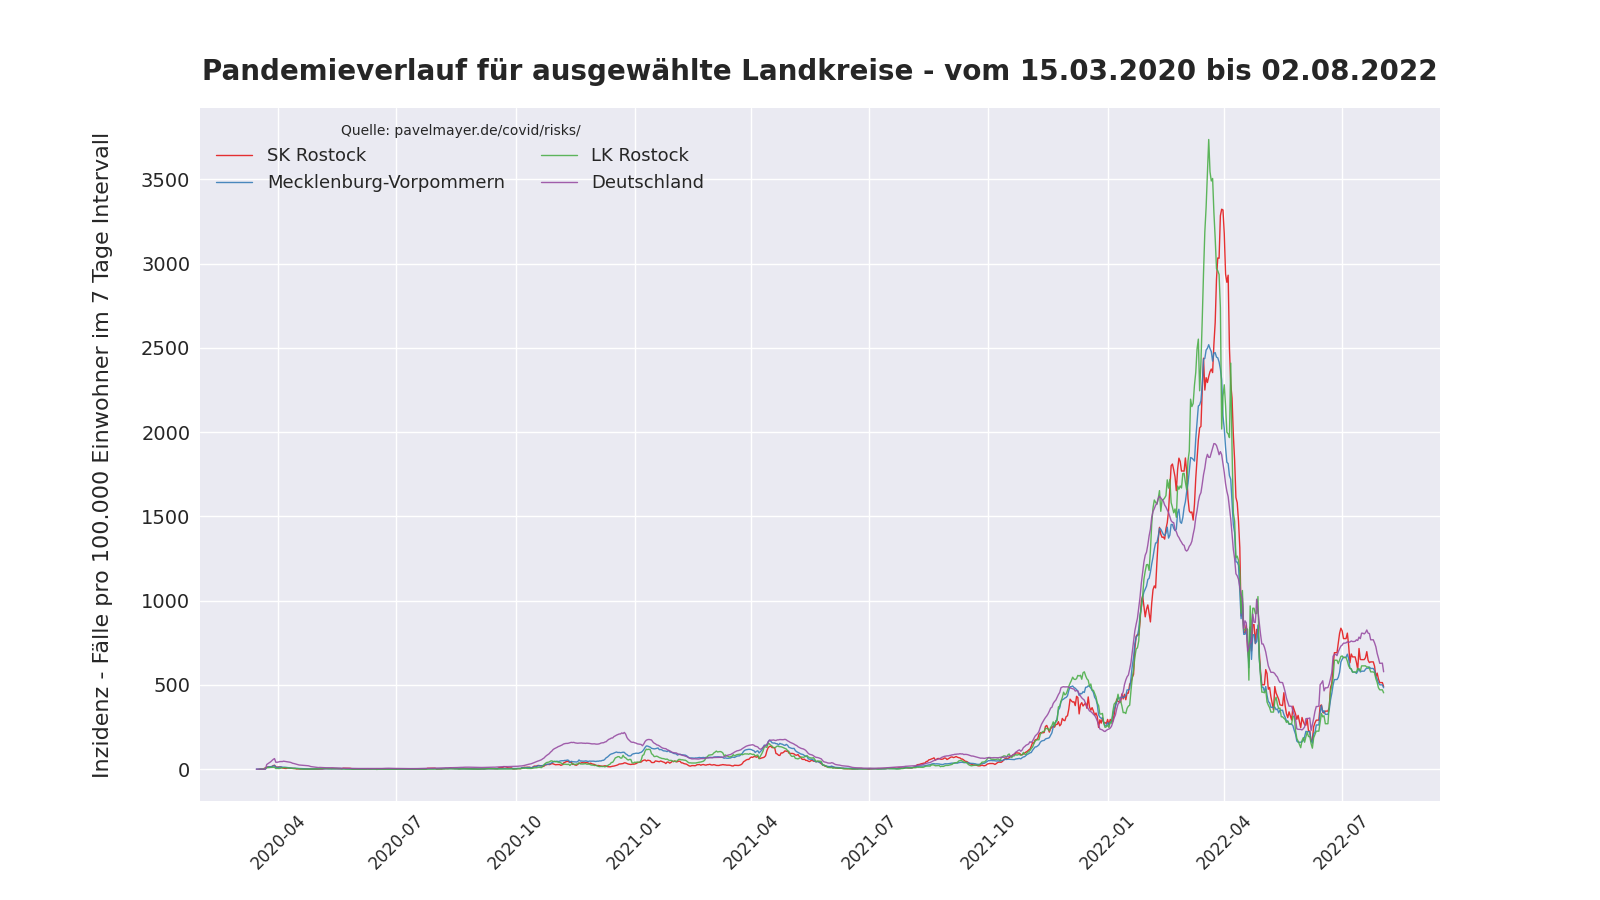
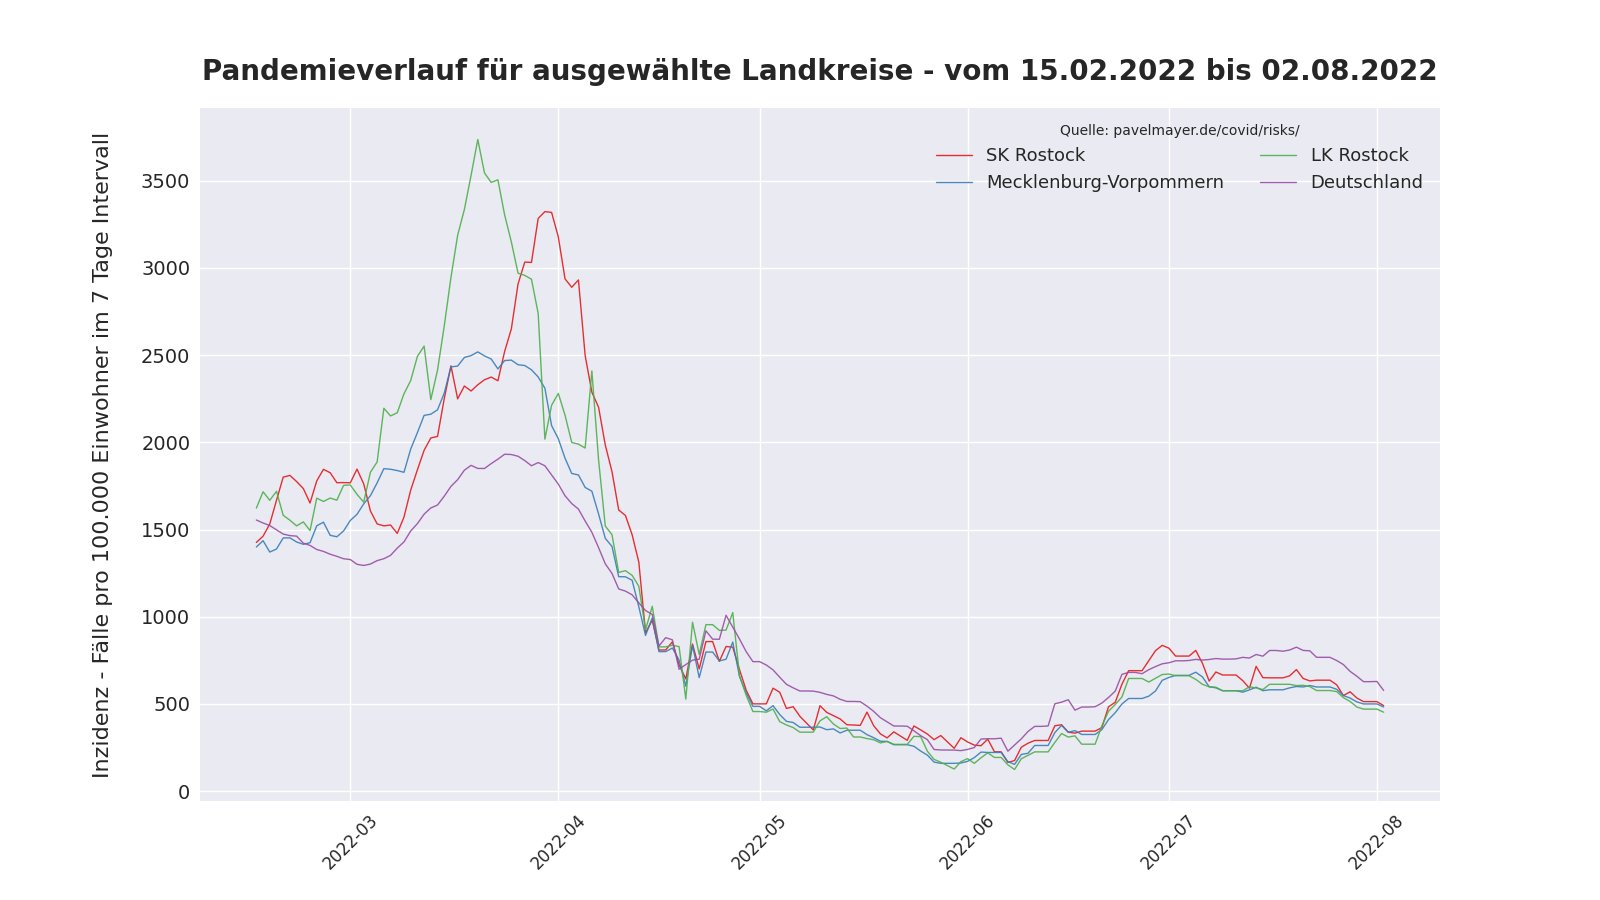
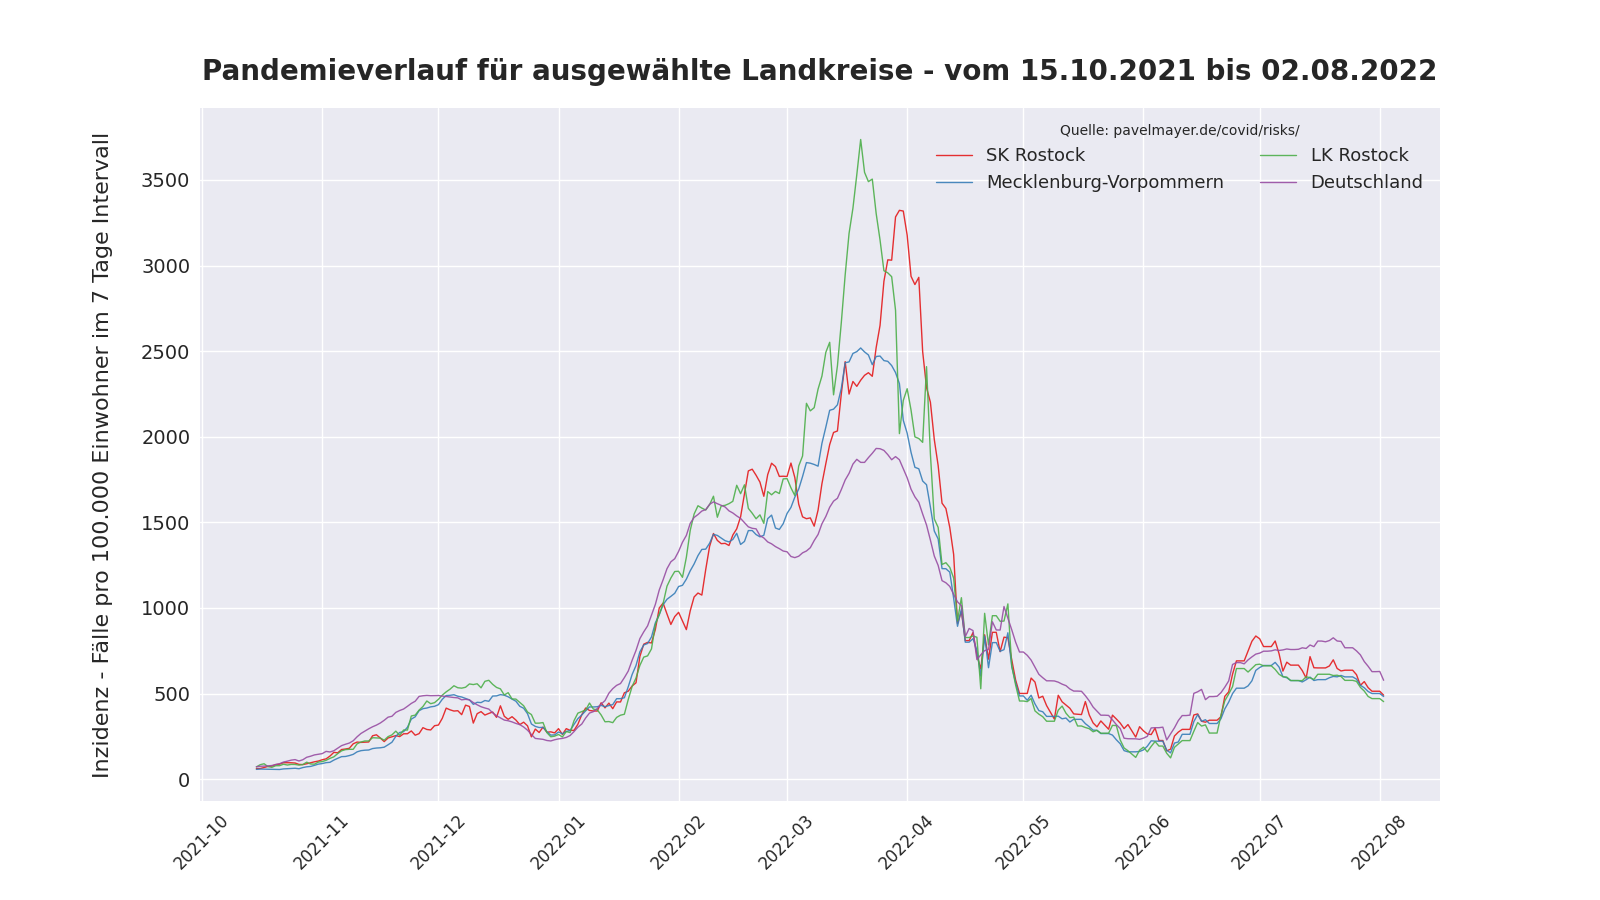
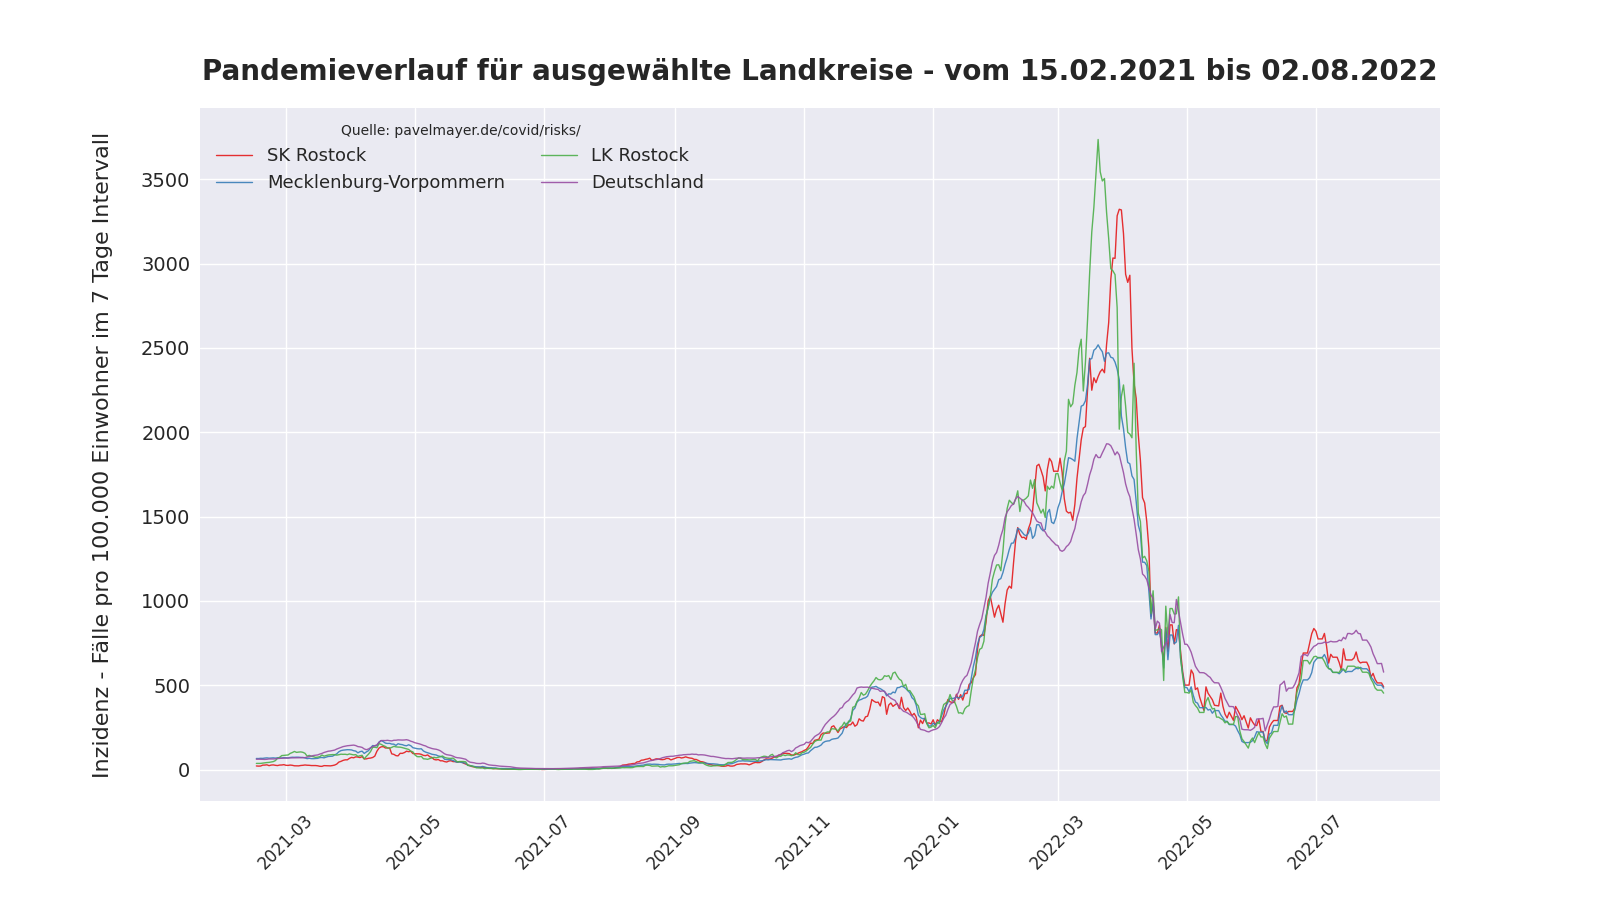
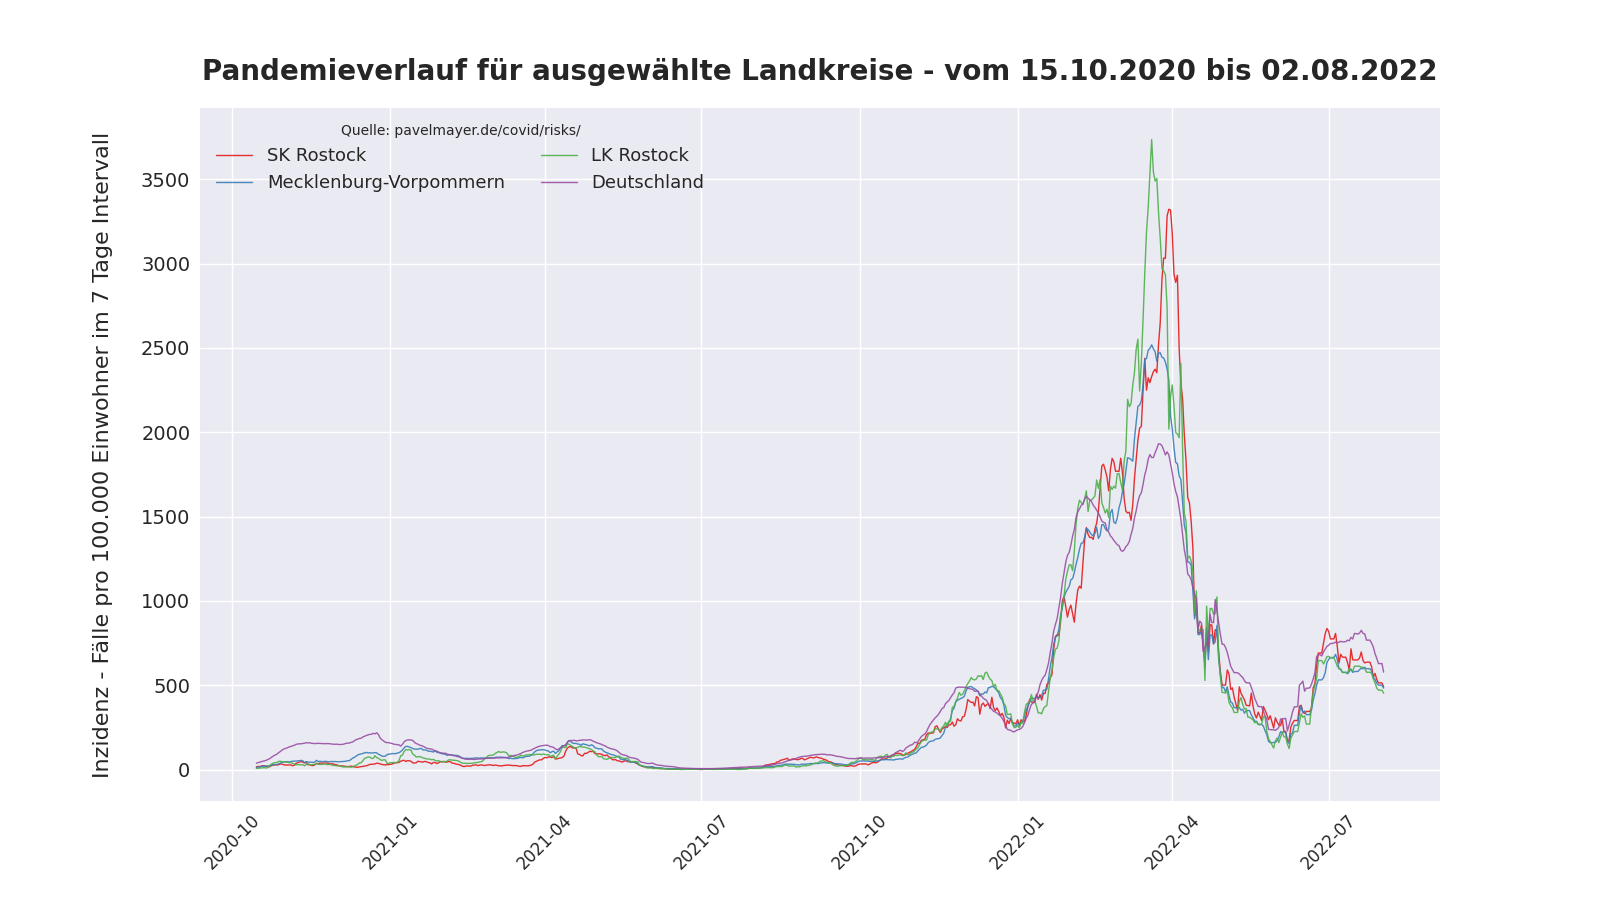
Im Bereich covid19-plot wurde ein neues Diagramm hinzugefügt. Es zeigt den bisherigen Verlauf der Pandemie anhand der Inzidenz (Fälle pro 100.000 Personen) für Rostock, Mecklenburg-Vorpommern und Deutschland.
Für ein zukünftiges Projekt würde ich gerne die Qualität von Kompressionsalgorithmen für das folgende Problem bewerten: Es sollen viele kleine Objekte mit pickle serialisiert und über ein Netzwerk übertragen werden. Die Objekte können sich in ihrer Größe unterscheiden, werden aber grundsätzlich nicht zu komplex. Auch ganze Warteschlangen, bestehend aus diesen Objekten, sollen übertragen werden. Für die Vergleiche werden folgende Objekte zufällig generiert (als BNF notiert):
Objekt      = id, timestamp, {value}, description
id          = ? int64 ?
timestamp   = ? int32 ?
value       = float
description = {Character}
Character   = ? printable ASCII characters ?
Als Kompressionsalgorithmen kommen zlib, zstd, lz4 und lzo in Frage. bz2 und lzma reduzieren den benötigten Platzbedarf zwar am meisten, sind aber auch erheblich langsamer als der Rest. Die benötigte Zeit ist das ausschlaggebende Kriterium. Da mich das Verhalten im Zusammenspiel mit Python3 interessiert, wurden die Vergleiche auch mit Python3 (3.9.1) durchgeführt. Dabei wurden folgende externe Module verwendet:
Die Module zlib, bz2 und lzma sind Teil der Standardbibliothek.
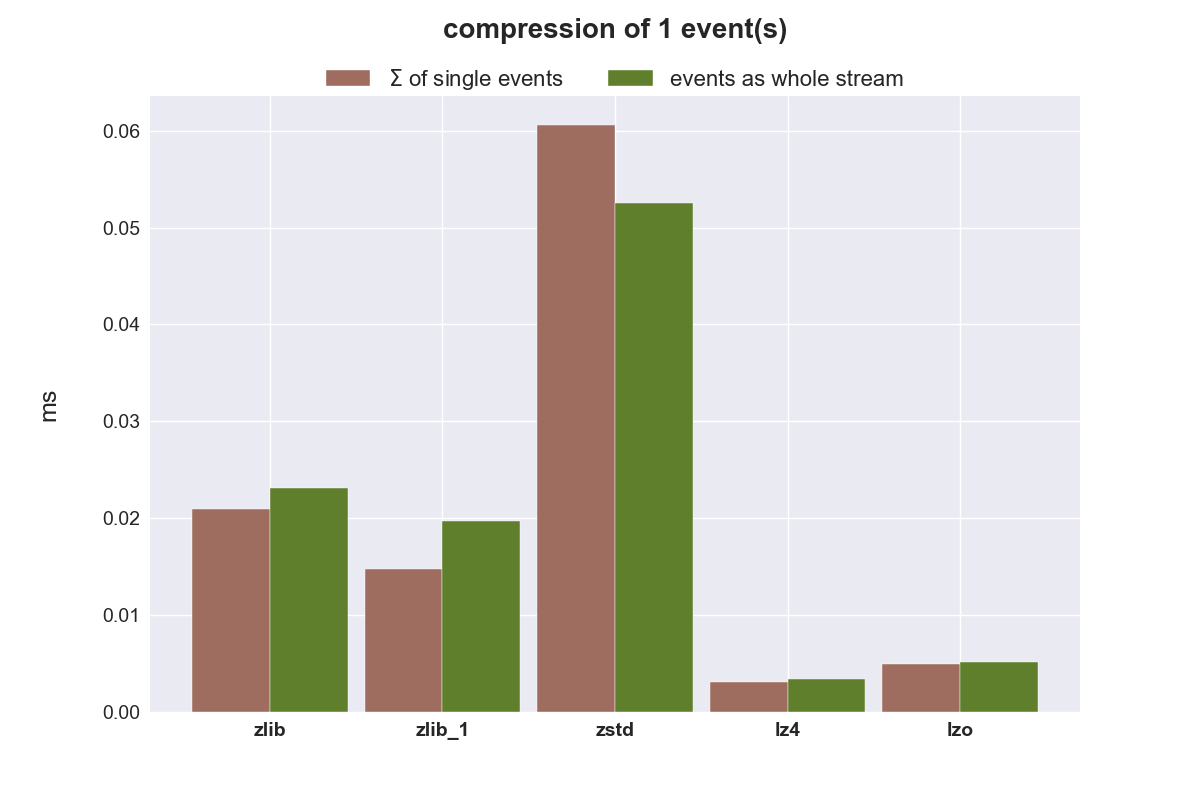
Kompression eines einzelnen Objektes
Die folgende Grafik zeigt die benötigte Zeit (Millisekunden), um ein Objekt einzeln und innerhalb einer Liste zu komprimieren.
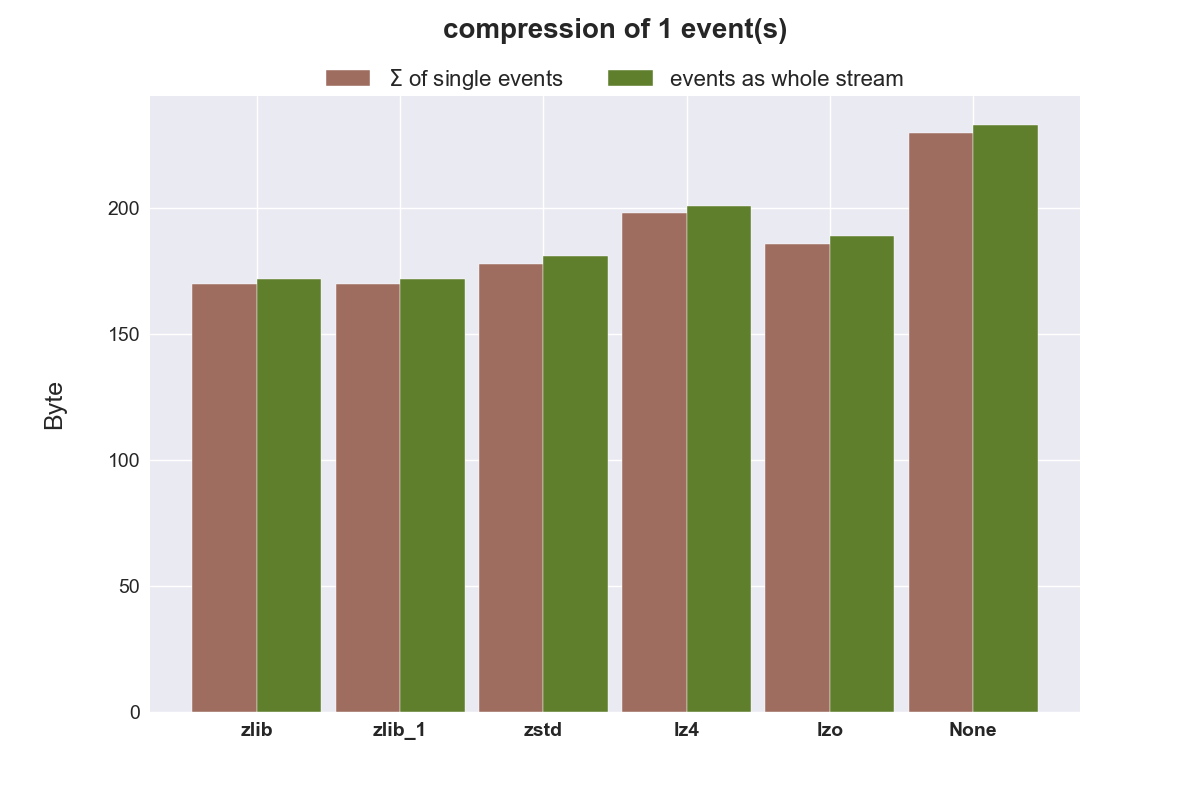
Hier wird die Größe in Byte nach der Kompression gezeigt. None ist die Größe der Quelldaten.
Kompression von 100.000 Objekten
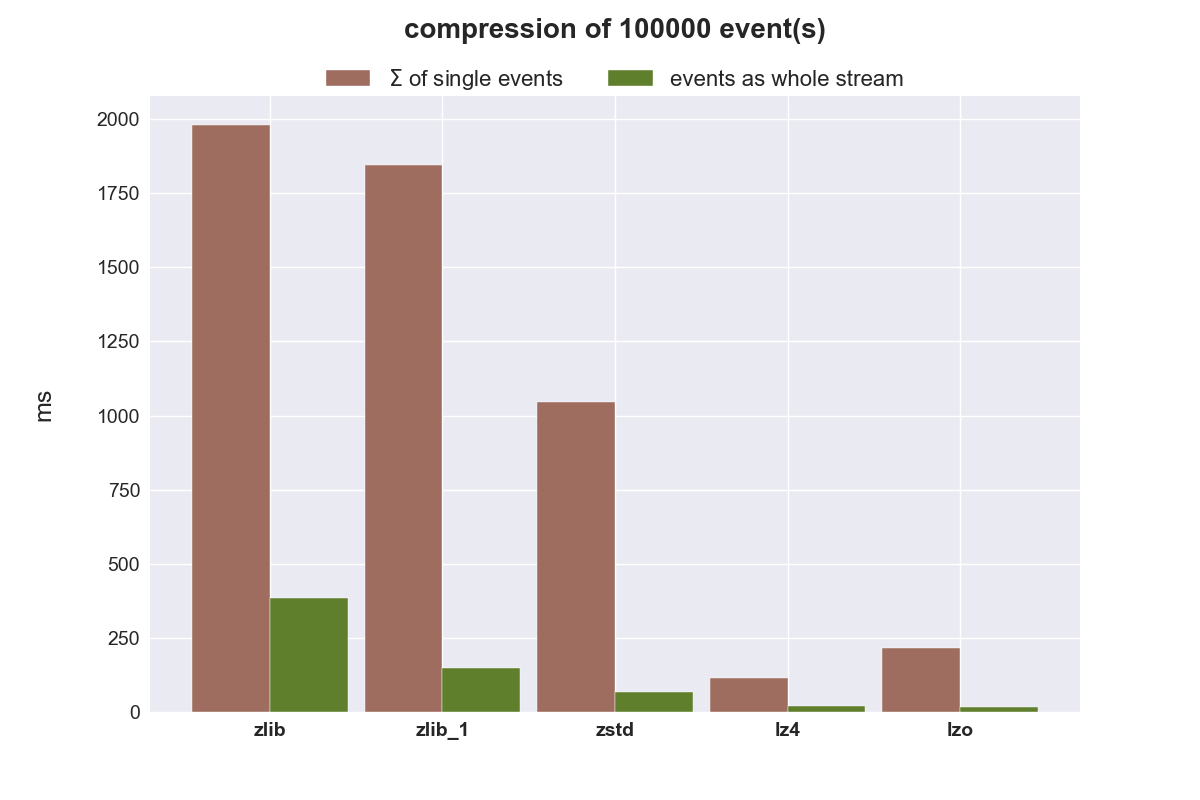
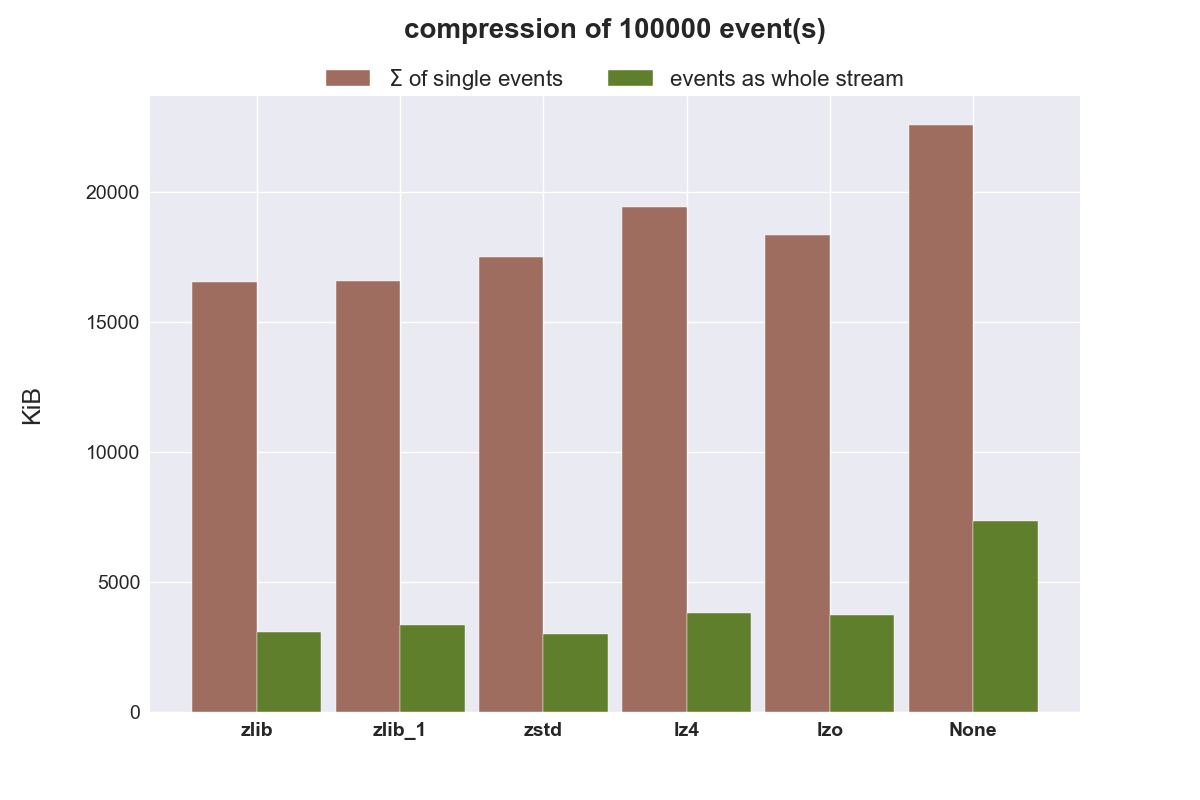
Nachfolgende Plots zeigen die aufsummierte Zeit und Datenmenge, wenn 100.000 Objekte einzeln komprimiert werden und zusammen als Liste.
Dekompression der Objekte
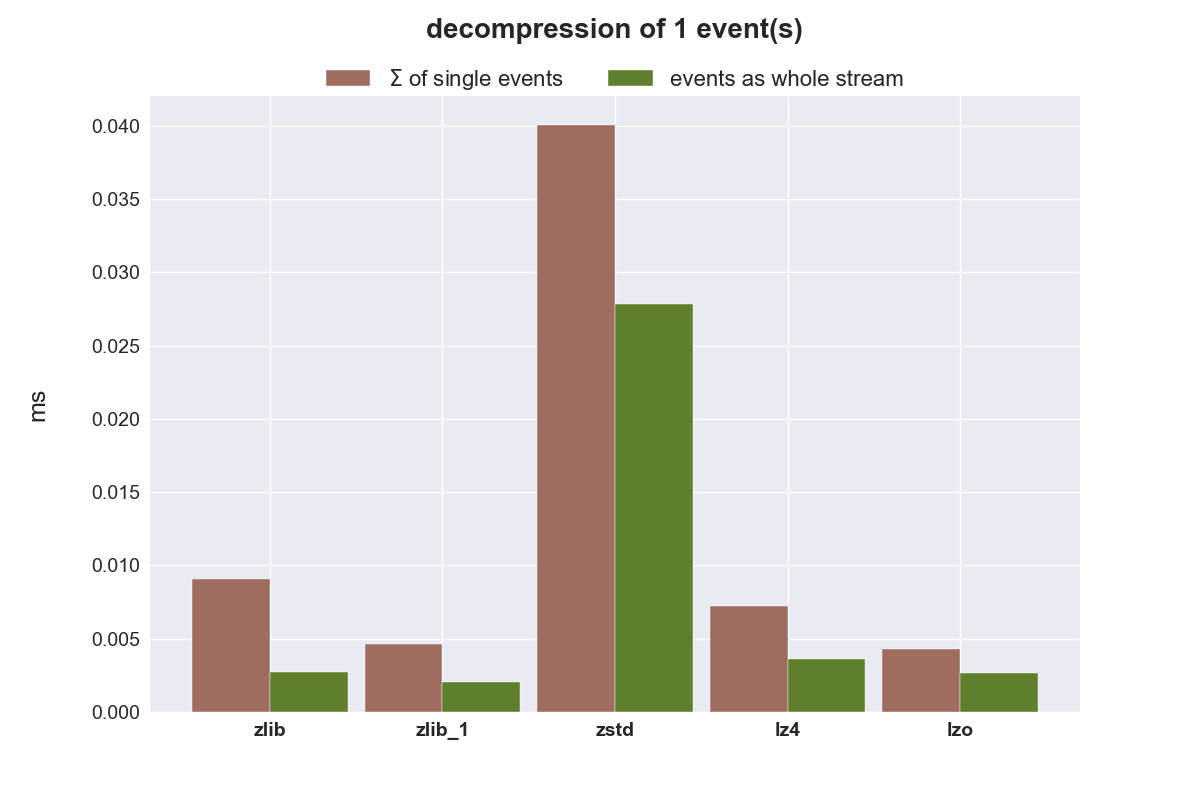
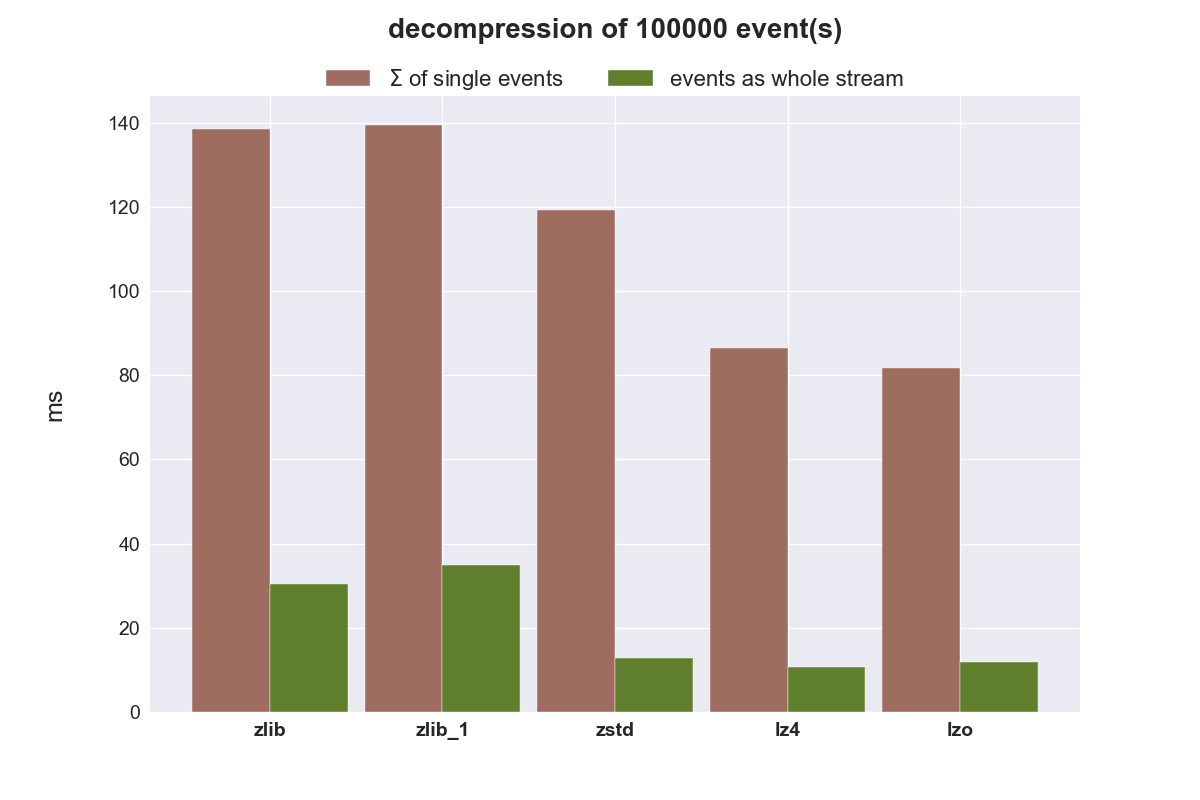
Zum Schluss wird noch die benötigte Zeit für die Dekompression der Daten verglichen.
Fazit
Pickle arbeitet sehr schnell und legt die serialisierten Daten effizient ab. Wenn 100K Objekte in einer Liste verpackt werden, benötigen diese nur 1/3 des Speicherplatzes, als wenn jedes Objekt einzeln serialisiert wird.
Einzelne Objekte (Events) zu komprimieren und sie im Anschluss zu übertragen scheint ineffizient zu sein. Der eingesparte Speicherplatz für diese kleinen Objekte ist einfach zu gering. Bei größeren Objekten könnte eine Kompression wieder sinnvoll sein. Man könnte größere Objekte soweit komprimieren, dass sie in ein einzelnes TCP/UDP-Segment passen.
zlib ist einfach zu langsam, auch mit dem niedrigstem Kompressionslevel (zlib_1). zstd eignet sich überhaupt nicht, um kleine Datenmengen zu komprimieren, schneidet aber bei größeren Datenmengen hervorragend ab. zstd reduziert den benötigten Speicherplatz am besten, benötigt zur Kompression aber mehr Zeit als lzo und lz4, ist jedoch bei der Dekompression nur minimal langsamer als diese beiden sehr schnellen Algorithmen. zstd wäre damit der beste Kandidat, um komplette Warteschlangen zu komprimieren zu übertragen.
Soll eine Kompression von einzelnen Events erfolgen, ist lz4 der favorisierte Kandidat. Er komprimiert und dekomprimiert einfach am schnellsten.
Eine kurze Kritik über die Funktion automatisch Auschecken der LUCA-App und warum diese unter Android derzeit nicht funktionieren kann, sowie die Konsequenzen, die daraus für Nutzer der LUCA-App und Betreiber entstehen können.
Update
[26.03.2021] Seit heute ist im Google-Playstore die Berechtigung für den Standortzugriff ausgewiesen (Version 1.4.12). Wenn man die App allerdings installiert, existiert diese Berechtigung nicht. Damit ist die App immer noch nicht in der Lage einen automatischen Checkout vorzunehmen.
[21.04.2021] Seit dem 26.03.2021 hat sich am Zustand der App nichts geändert.
LUCA-App in Mecklenburg-Vorpommern
Mecklenburg-Vorpommern ist das erste Bundesland, das eine Betreiberlizenz für die LUCA-App erworben hat. Es wird offensiv mit der Nutzung der App geworben. Der Preis dieser Lizenz ist unbekannt.
Allgemeine Kritik an der Luca-App
Ich beziehe mich im Folgenden auf die Android-Version der LUCA-App.
Ich befürworte ausdrücklich die Nutzung von IT-Lösungen zum Zweck der Kontaktnachverfolgung. Die Corona-Warn-App ist ein gutes Beispiel für eine datenschutzfreundliche und offene Lösung, der Entwicklungsprozess ist komplett transparent und auch das zugrunde liegende Exposure Notification Framework von Google ist mittlerweile im Quellcode verfügbar. Zudem gibt es einen Google-freien Nachbau des Frameworks vom MicroG-Projekt und auch einen Fork der originalen Corona-Warn-App namens Corona Contact Tracing Germany , die das MicroG-Exposure-Framework verwendet. Der einzige Kritikpunkt an der Corona-Warn-App könnten die hohen Entwicklungskosten sein. Wie viel die LUCA-Lizenzen in Summe kosten ist aber auch noch unklar. Aus Datenschutzgründen hat man sich im November 2020 entschieden, keine Kontaktnachverfolgung im Sinne der LUCA-App in die Corona-Warn-App zu integrieren, um nicht das Vertrauen in die App zu verspielen. Stattdessen nehmen wir einfach eine nicht überprüfte Software von einem Berliner Start-up?
Genau die oben beschriebenen Vorteile, die auch das Vertrauen in die LUCA-App stärken würden, dass unabhängige Experten sich den Code anschauen könnten und Verbesserungsvorschläge einreichen können, fehlen in der LUCA-App komplett. Stattdessen setzt man offensichtlich auf eine strikt proprietäre Lösung, die nicht einmal einen Audit durch externe Firmen erfahren hat. Zudem werden Lizenzverhandlungen hinter verschlossenen Türen durchgeführt.
LUCA-App verwendet Geofencing - oder doch nicht?
Seit Montag, dem 01.03.2021, ist es Frisören in MV wieder erlaubt, zu öffnen. Natürlich mit der Bitte, die LUCA-App zu verwenden. Eine Frisörmeisterin aus Rostock hat im Lokalradio von ihren Erfahrungen mit der LUCA-App berichtet. Sinngemäß wurde die Möglichkeit gelobt, im Betreiber-Modus einen Radius zu erstellen, aus dem man automatisch ausgecheckt wird: Ist ein Nutzer mit der LUCA-App im Frisörsalon eingecheckt und verlässt den voreingestellten Radius, wird er automatisch ausgecheckt. Für die Frisörmeisterin eine hervorragende Funktion, Kunden müssen sich somit nicht manuell auschecken.
Wie funktioniert das automatische Auschecken?
Ganz einfach: Die Position des Smartphones muss zu jedem Zeitpunkt bekannt sein. Kurz gesagt, die LUCA-App braucht Zugriff auf die Ortungsfunktionen des Smartphones. Ortungen mit metergenauer Auflösung könnten folgendermaßen durchgeführt werden:
- Verwendung des GPS/GLONASS/Galileo-Empfängers des Smartphones
- sehr genau
- nur außerhalb von Gebäuden
- Ungenaue Ortung mittels bekannter Netzwerke (WiFi, Cell-Based)
- Externe Datenbanken müssten angefragt werden (Google-Services)
- Genauigkeit hängt von der Datenqualität der entsprechenden Region ab
- Ortung mittels Funkfeuer (zum Beispiel mittels Bluetooth-Low-Energie-Beacons)
- Stark begrenzte Reichweite (wenige Meter)
- Ungenau
- Smartphone des Betreibers oder spezielle BLE-Sender müssten BLE-Beacons aussenden
Alle drei Verfahren benötigen aber Zugriff auf die Standortdaten des Android-Smartphones. Das automatische Auschecken auf Basis von Standortdaten scheint optional zu sein, das wird aber im Betreiber-Modus, während der Eintragung eines Radius nicht erwähnt.
Zusätzlich existiert noch die Möglichkeit, eine sehr grobe Standortbestimmung mittels IP-Adressen vorzunehmen. Dieses Verfahren ist aber für die metergenaue Bestimmung unbrauchbar und auch nicht zuverlässig. Je nach Qualität der Daten kann man lediglich die Region (z.B. Stadt) bestimmen, in der man sich aufhält. Diese Bestimmung benötigt keine gesonderten Berechtigungen auf dem Smartphone.
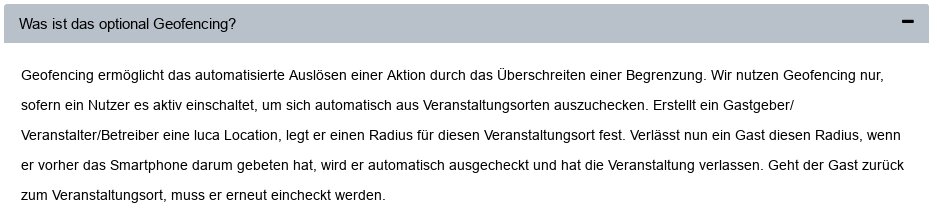
Nur die FAQ auf der Homepage bietet eine kurze Bemerkung, aber nicht wie Geofencing in der LUCA-App umgesetzt ist.
Automatisches Auschecken kann zur Zeit unter Android nicht funktionieren
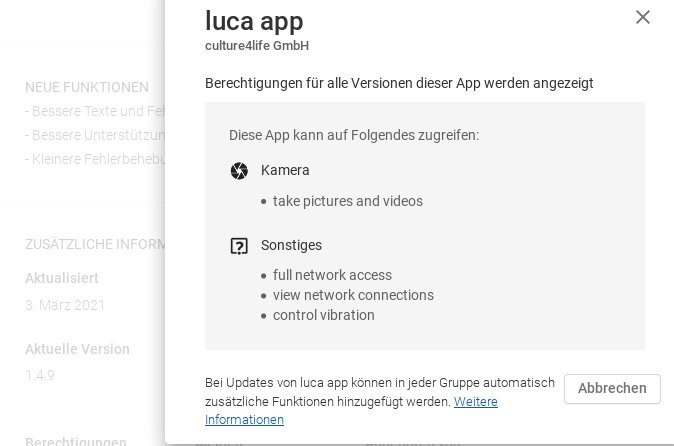
Wie schon erwähnt, müsste die LUCA-App Zugriff auf die Standortdaten haben, um überhaupt das metergenaue automatische Auschecken zu ermöglichen. Derzeit wird diese Funktion durch die Android-App (Version 1.4.9) überhaupt nicht angeboten. Die Berechtigungen der App im Play-Store gibt eindeutig Auskunft darüber:
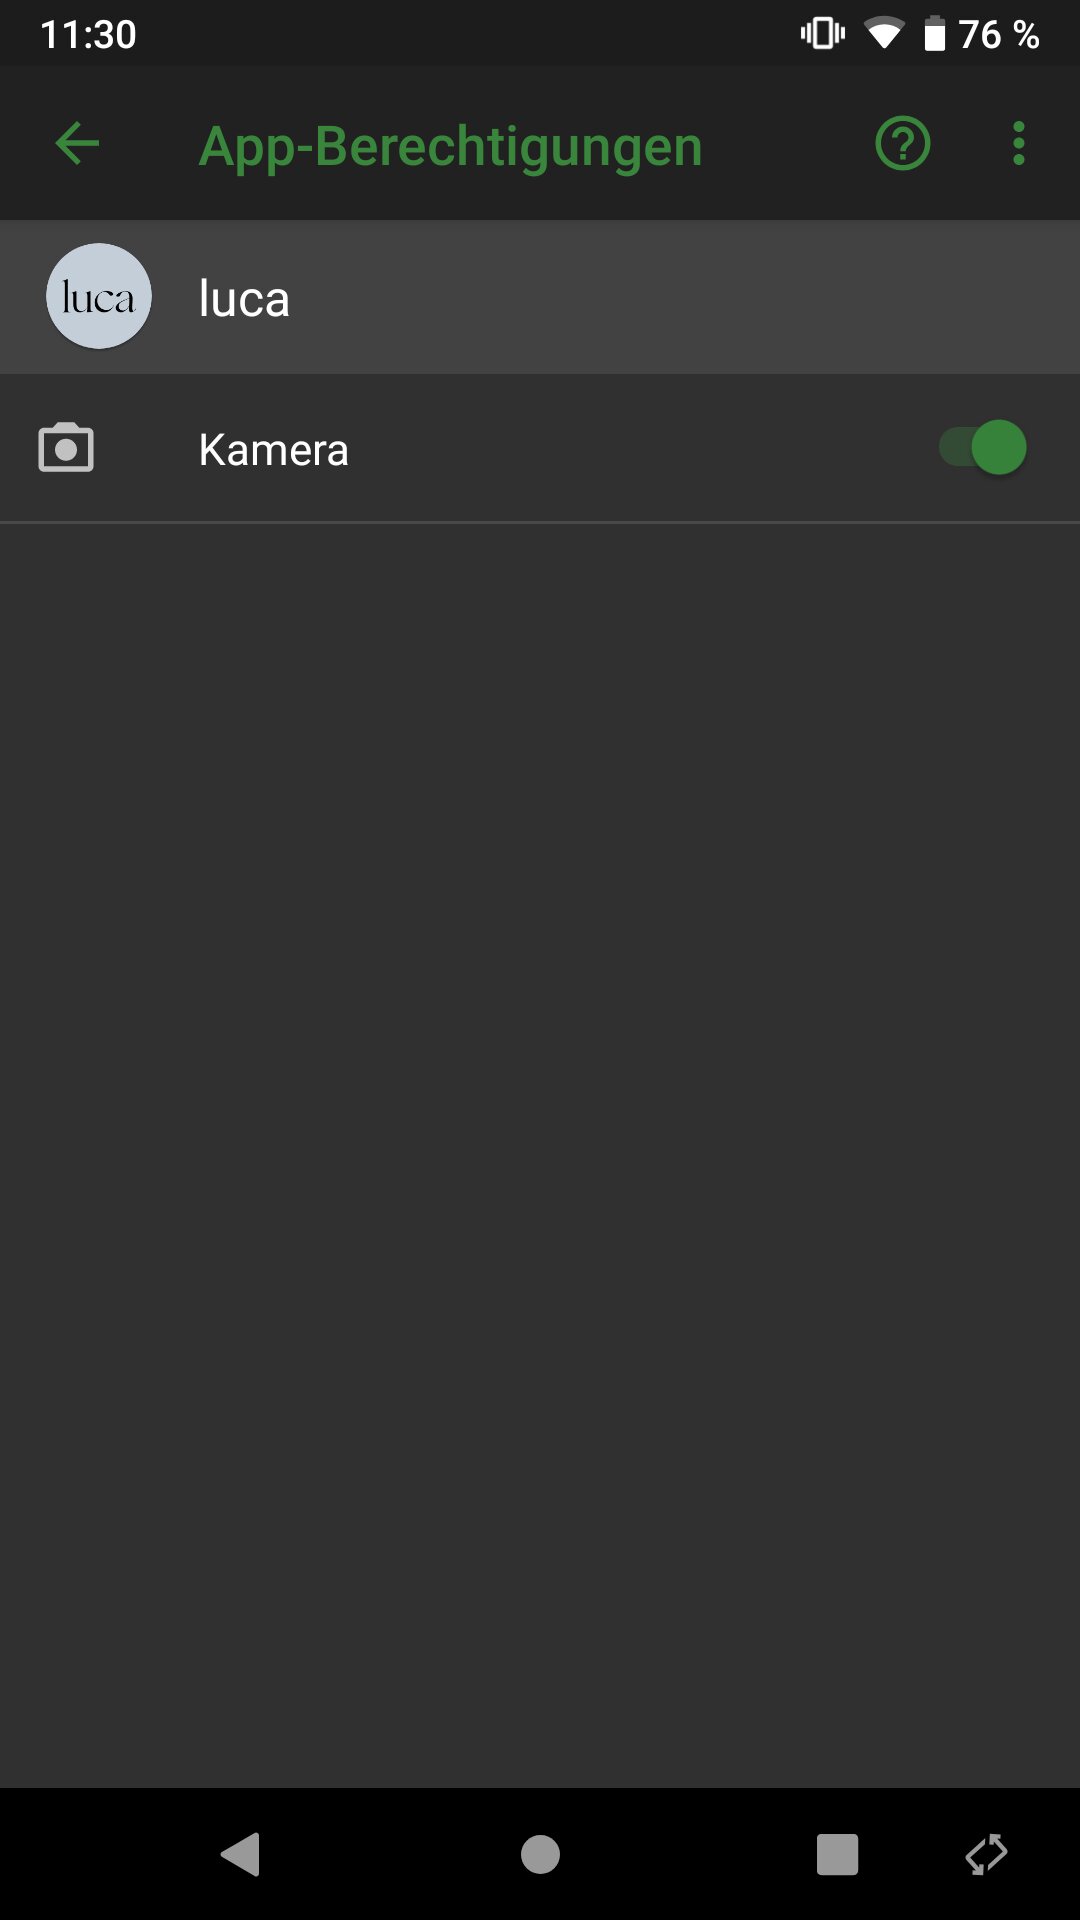
Auch nach der Installation der App existiert keine Möglichkeit der Standortabfrage:
Wie soll metergenaues Auschecken unter Android so möglich sein? Gar nicht!
Die iOS-Version der App (Version 1.3.1) scheint die Möglichkeit der Standortabfrage zu bieten.
Abseits großer datenschutzspezifischer Bedenken, dass ein Unternehmen somit in der Lage wäre, Bewegungsdaten tausender Menschen zu erfassen, kann diese Funktion einfach nicht benutzt werden.
Konsequenzen
Das automatische Auschecken wird im Betreiber-Modus der LUCA-Web-App zentral beworben, kann aber nicht funktionieren. Wenn sich technisch nicht versierte Betreiber und Gäste auf diese Funktion verlassen, ist das in meinen Augen ein schwerer Fehler. Es kann sogar dazu führen, dass eigentlich unbeteiligte Betreiber in Quarantäne müssen und so eventuell ihren Geschäftsbetrieb einstellen oder einschränken müssen, da sich Gäste eigentlich woanders infiziert haben, aber nicht ausgecheckt waren. Das kann natürlich auch Gäste treffen, die sich auf das automatische Auschecken verlassen und später eine Quarantäne-Aufforderung bekommen, obwohl sie schon lange nicht mehr vor Ort waren.
Forderung an die Entwickler der LUCA-App
Rücknahme der Geofencing-Funktionen aus Datenschutzgründen und aufgrund unvollständiger Unterstützung des eigenen Softwarestacks.
Klare und detaillierte Beschreibung der Architektur.
Audit des gesamten LUCA-Softwarestacks durch mindestens zwei unabhängige Unternehmen.
Forderung an Regierungen und Städte die eine LUCA-Lizenz erworben haben
Veröffentlichung von Preislisten oder gezahlten Preisen für Lizenzen.
Druck auf die Entwickler erhöhen, den Code (Apps + Server) zu publizieren (public money public code!).
- Zum Beispiel Kauf des Start-up und Umwandlung in Bundes-/Landeseigene Unternehmung
Impfmonitoring
Alle Grafiken werden stündlich aktualisiert, sofern neue Daten zur Verfügung stehen.
Der Quellcode steht auf GitHub zur Verfügung.
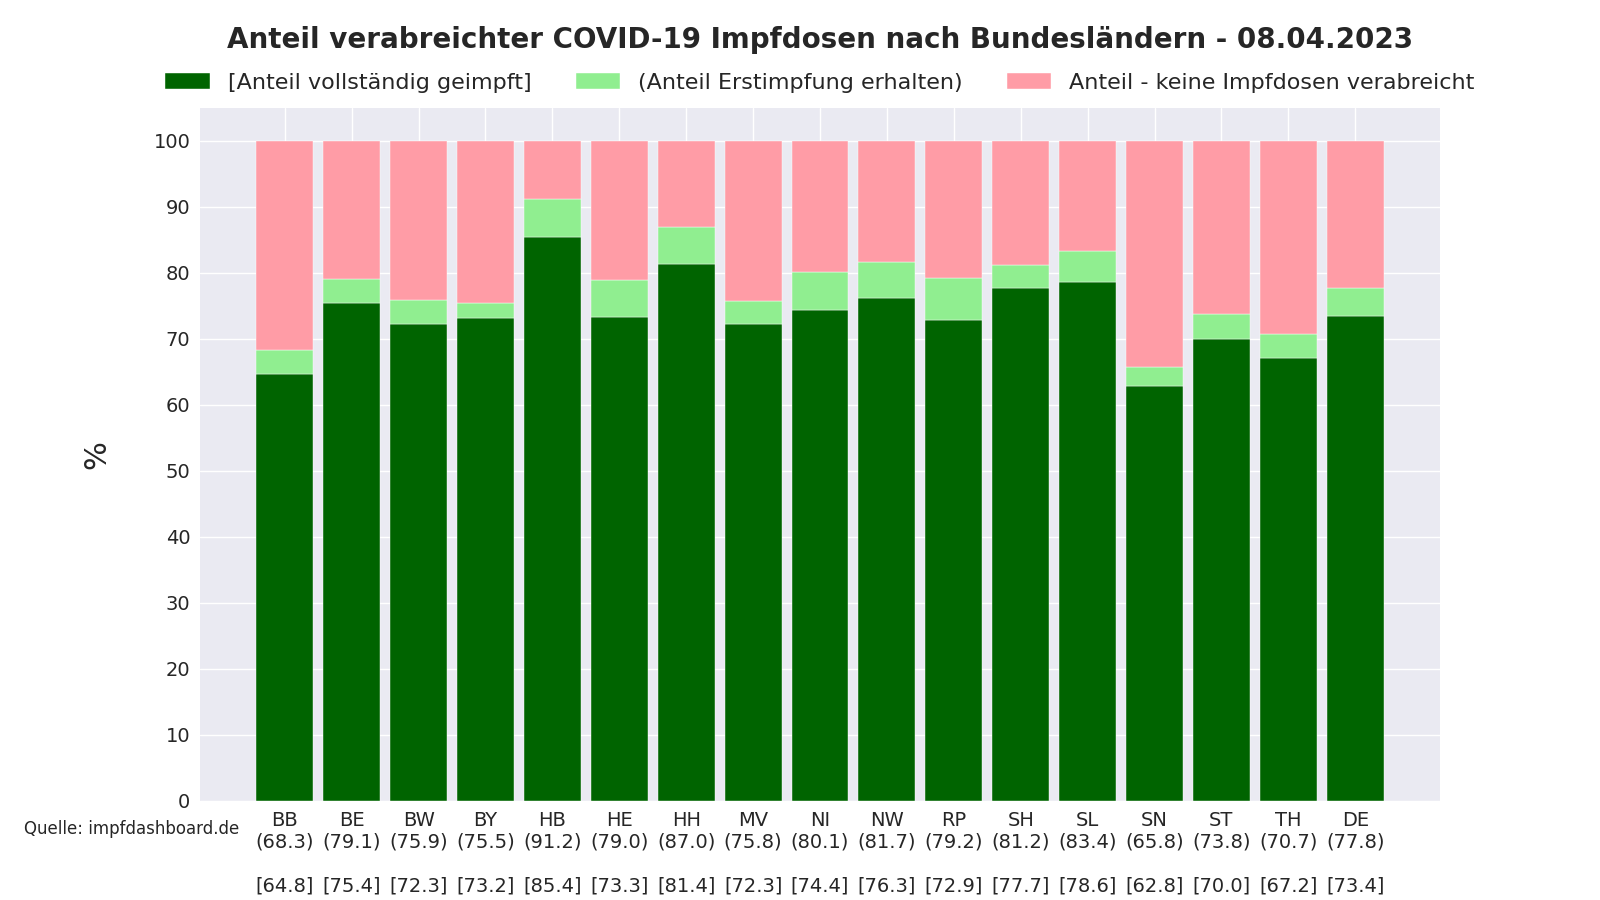
Folgender Plot zeigt den nach Bundesländern aufgeschlüsselten Impffortschritt an. Als Quelle dienen Daten vom Impfdashboard.
Pandemieverlauf in Rostock
Folgender Plot basiert auf den Daten aus Pavel Meyers Covid-Risiko-Tabelle. Das erzeugende Skript kann beliebige Landkreise, Städte oder Länder plotten und ist auf GitHub veröffentlicht.
Updates
[11.06.2022] Neue Plots für die Zeiträume vom 15.10.2021 und 15.02.2022
[06.04.2021] Plot zum Verhältnis von gelieferten zu verimpften Dosen hinzugefügt.
[16.03.2021] Plot zum Pandemieverlauf hinzugefügt.
[11.02.2021] Es wird nach Erst- und Zweitimpfung unterschieden.
[19.01.2021] Umstrukturierung der RKI-Tabelle, inkompatibel zur vorherigen Version. Es existiert jetzt eine Aufschlüsselung nach Impfpräparaten.
[04.01.2021] Das RKI stellt seit heute auch die Impfquote pro 1000 Einwohnern und die Gesamtanzahl der Impfungen der letzten Tage in ihrer Excel-Tabelle bereit.
Alternativen:
Nachtsieb
about / Impressum
Martin Steinbach
get my public key
@martin:nachtsieb.de
codeberg.org/nachtsieb
github.com/meetunix